Kısaca özet
- Yapay zeka botları, dil modellerini eğitmek, yapay zeka aramalarına kaynak bulmak ya da bir kullanıcının sorusu üzerine sayfanızı okumak için sitenizi gezen yazılımlardır; üçü ayrı işler yapar ve ayrı ayrı yönetilir.
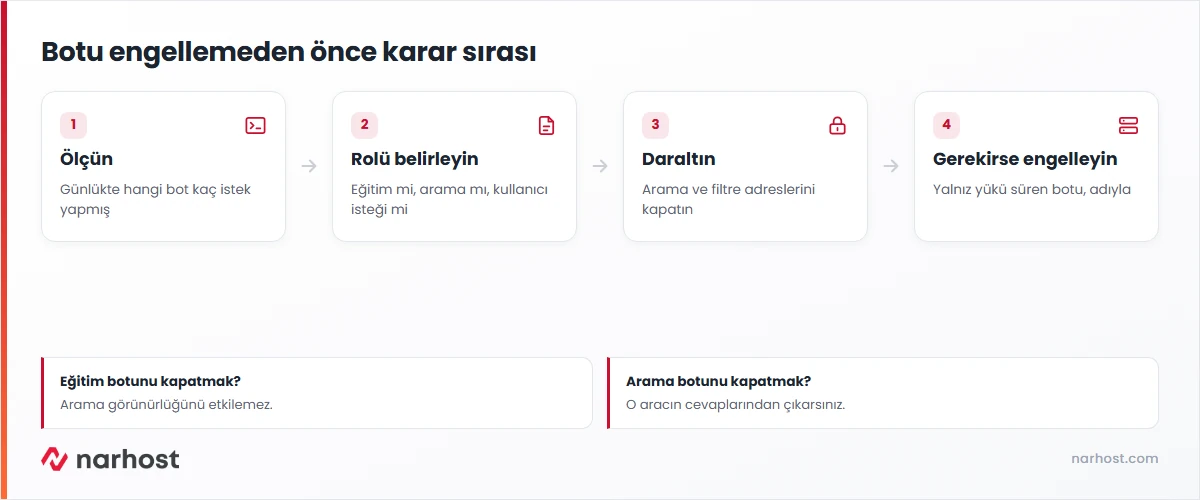
- Eğitim botunu engellemek arama görünürlüğünüzü etkilemez; arama botunu engellemek ise sitenizi o yapay zeka aracının cevaplarından çıkarır.
- OpenAI bunu açıkça yazar: OAI-SearchBot’u engelleyen siteler ChatGPT arama cevaplarında gösterilmez; GPTBot ise yalnız eğitimle ilgilidir.
- Google-Extended bir bot değil, robots.txt’de kullanılan bir denetim adıdır; Google Arama’ya dahil olmayı ve sıralamayı etkilemez.
- Müşterisi yapay zeka araçlarına soru soran bir işletme için toptan engelleme, görünürlükten vazgeçmek demektir.
- Sorun sunucu yüküyse çözüm çoğu zaman engellemek değil sınırlamaktır: yükü hangi botun yaptığı erişim günlüğünden bulunur ve yalnız o bot yavaşlatılır.
Hosting panelinde CPU grafiği yükselmiş, erişim günlüğünde daha önce görmediğiniz adlar var: GPTBot, ClaudeBot, PerplexityBot. İlk tepki hepsini kapatmak olur. Aynı hafta bir müşteriniz sizi bir yapay zeka asistanına sorarak bulduğunu söyler. İki olay aynı kararın iki ucudur ve tek bir robots.txt satırıyla ikisini birden kaybetmek mümkündür.
Yapay Zeka Botları Kaç Türdür
Hepsi aynı işi yapmaz. Büyük sağlayıcılar botlarını üç role ayırıyor ve her rol için ayrı bir ad kullanıyor. Ayrım önemlidir, çünkü robots.txt kuralları bot adına göre yazılır.
| Rol | Ne yapar | Örnek adlar | Engellerseniz |
|---|---|---|---|
| Eğitim | Model eğitiminde kullanılabilecek içerik toplar | GPTBot, ClaudeBot, Google-Extended | İçeriğiniz gelecekteki eğitim verisine girmez; arama görünürlüğü değişmez |
| Arama | Yapay zeka aramasında kaynak gösterilecek sayfaları dizine alır | OAI-SearchBot, Claude-SearchBot | O aracın cevaplarında kaynak olarak görünmezsiniz |
| Kullanıcı isteği | Biri soru sorduğunda sayfayı o an açıp okur | ChatGPT-User, Claude-User | Kullanıcı sizin sayfanızı sorduğunda araç içeriğe ulaşamaz |
Tablodaki tanımlar sağlayıcıların kendi belgelerinden alındı. OpenAI’nin bot belgesi GPTBot’un eğitim, OAI-SearchBot’un arama için kullanıldığını ve ikisinin ayarlarının birbirinden bağımsız olduğunu söylüyor. Anthropic’in yardım sayfası da aynı üçlü ayrımı ClaudeBot, Claude-SearchBot ve Claude-User adlarıyla yapıyor.
Engellemek Arama Görünürlüğünü Nasıl Etkiler
Google tarafında durum nettir. Google’ın tarayıcı listesi, Google-Extended’ın ayrı bir bot değil, içeriğin Gemini modellerinin eğitiminde ve cevaplarında kullanılıp kullanılmayacağını yöneten bir denetim adı olduğunu yazıyor; Google Arama’ya dahil olmayı etkilemediğini ve sıralama sinyali olmadığını da ekliyor. Yani bu adı engellemek klasik arama sonuçlarındaki yerinizi değiştirmez.
Yapay zeka aramalarında ise sonuç doğrudandır. OAI-SearchBot’u engelleyen site ChatGPT’nin arama cevaplarında kaynak olarak gösterilmez. Claude-SearchBot’u engellemek, Anthropic’in ifadesiyle, kullanıcı aramalarındaki görünürlüğü ve doğruluğu azaltabilir. Bu araçlar bir soruya cevap verirken az sayıda kaynak gösterir; orada yer almak ya da almamak, aracın sizi hiç anmaması ile adınızla önermesi arasındaki farktır.
Bilgi
Kullanıcı isteğiyle çalışan botlar için robots.txt her zaman bağlayıcı olmayabilir. OpenAI, ChatGPT-User bir kullanıcının isteğiyle hareket ettiği için robots.txt kurallarının uygulanmayabileceğini belirtiyor. Bu botları kesin olarak durdurmanın yolu sunucu tarafında engellemektir.
Sunucu Yükü Gerçekten Yapay Zeka Botlarından mı
Bazen evet, çoğu zaman kısmen. Karar vermeden önce ölçmek gerekir. Erişim günlüğünde kullanıcı aracısına göre istek sayısına bakın: bir günde hangi bot kaç sayfa istemiş, bunların kaçı önbelleğe alınamayan arama ve filtre sayfaları. Paylaşımlı hostingde yük sınırı dolduğunda ziyaretçi 508 hatası görür; sınırların ne olduğu paylaşımlı hostingte kaynak limitleri yazısında anlatılıyor.
Günlükte iki ayrı tablo çıkabilir. Birincisinde adını açıkça söyleyen tanınmış bir bot makul hızda geziyordur; yük küçüktür ve engellemenin kazancı sınırlıdır. İkincisinde bir bot filtre kombinasyonlarını ya da takvim sayfalarını sonsuz döngüde tarıyordur; yük büyüktür ama sorun botun kimliği değil, sitenin ona sonsuz adres sunmasıdır. Kimliğini gizleyen kazıyıcılar ise ayrı konudur ve bot trafiği nedir yazısında ele alındı.
Örnek senaryo
Bir seyahat acentesinin sitesinde CPU kullanımı iki hafta boyunca her gece sınıra dayandı. Günlükte tek bir eğitim botunun tur takvimi sayfalarını tarih tarih gezdiği, günde 40 bin istek yaptığı görüldü. Acente o botu engellemedi; takvim adreslerini robots.txt ile bütün botlara kapattı ve eğitim botu için site genelinde tarama izni bıraktı. İstek sayısı günde 600’e indi. Arama botlarına hiç dokunulmadı; acente bir yapay zeka asistanının cevaplarında kaynak olarak görünmeye devam ediyor.
Hangi İşletme Neyi Engellemeli
Karar içeriğin ne işe yaradığına göre değişir. Ürün ya da hizmet satan bir işletme için içerik, müşteriyi siteye getiren araçtır; yapay zeka araçlarında anılmak kazançtır ve arama ile kullanıcı botları açık kalmalıdır. Eğitim botları için tercih serbesttir; engellemek görünürlüğe zarar vermez.
Geliri içeriğin kendisinden gelen yayıncı için hesap farklıdır: haber sitesi, ücretli araştırma, özgün veri. Burada eğitim botunu engellemek anlaşılır bir tutumdur. Arama botları yine de ayrı düşünülmelidir, çünkü kaynak gösterilen bir cevaptan gelen ziyaretçi de okurdur. Üyelik arkasındaki içerik ise zaten botlara kapalıdır ve ayrıca kural gerektirmez.
Dikkat
robots.txt dosyasına “bütün botları engelle” kuralı yazmak arama motorlarını da kapsar ve site dizinden düşer. Kural her zaman bot adına göre yazılır; genel yasak kullanılmaz.
Engellemek Yerine Sınırlamak
Çoğu sitede doğru hamle, botun girebileceği alanı daraltmaktır. Arama sonuç sayfaları, filtre kombinasyonları, sepet ve hesap adresleri hiçbir bota gerekmez; bunları kapatmak yükün büyük kısmını alır ve içerik sayfaları açık kalır. Robots.txt’ye uymayan ya da yükü süren bot için ikinci adım sunucu tarafında engellemedir. İki yöntemin de adımları yapay zeka botlarını robots.txt ve .htaccess ile sınırlama kartında.
Üçüncü katman önbellektir. Önbellekten sunulan sayfa PHP çalıştırmaz ve veritabanına gitmez; aynı bot aynı sayıda sayfa istese bile tükettiği kaynak düşer. Yoğun bot trafiği alan sitede önbellek, engelleme kurallarından daha kalıcı bir çözümdür. Bulut tabanlı bir güvenlik duvarının bu tabloda ne zaman gerekli hâle geldiği WAF gerekir mi yazısında.
Sonuç
Yapay zeka botları tek bir grup değildir. Eğitim botu için karar size kalmış bir tercihtir; arama ve kullanıcı botları ise müşterinizin sizi bulduğu yeni kapıdır. Yük sorunu varsa önce ölçün, sonra hangi adreslerin tarandığına bakın; toptan yasak en son seçenektir.
Kontrol Listesi
- Erişim günlüğünde son yedi günde en çok istek yapan on kullanıcı aracısını listeleyin.
- Her bot için rolünü belirleyin: eğitim, arama ya da kullanıcı isteği.
- Arama ve filtre gibi sonsuz adres üreten sayfaları robots.txt ile bütün botlara kapatın.
- Eğitim botları için kararınızı verin ve yalnız bot adıyla kural yazın.
- Arama botlarını açık bırakın; kapatacaksanız görünürlük kaybını kabul ettiğinizden emin olun.
- Sayfa önbelleğinin açık olduğunu doğrulayın.
- Bir ay sonra günlüğe yeniden bakıp kuralların etkisini ölçün.
Sıkça sorulan sorular
Yapay zeka botları engellenirse Google sıralamam düşer mi?
Yalnız eğitim botlarını ve Google-Extended adını engellerseniz düşmez; Google bu adın arama sonuçlarına dahil olmayı ve sıralamayı etkilemediğini belirtiyor. Googlebot’u engellerseniz site dizinden çıkar; ikisi karıştırılmamalıdır.
GPTBot’u engellersem ChatGPT sitemi önermez mi?
GPTBot eğitim içindir. ChatGPT’nin arama cevaplarında görünmeyi OAI-SearchBot belirler ve ayarları ayrıdır. GPTBot kapalı, OAI-SearchBot açık bir site, içeriğini eğitime vermeden arama cevaplarında kaynak olabilir.
robots.txt kuralı ne kadar sürede etkili olur?
Botlar dosyayı belirli aralıklarla yeniden okur. OpenAI, arama ile ilgili robots.txt değişikliklerinin yaklaşık 24 saat içinde dikkate alındığını yazıyor. Diğer sağlayıcılarda süre birkaç günü bulabilir.
Bot kendini başka adla tanıtırsa ne olur?
Tanınmış sağlayıcılar botlarını adlarıyla duyurur ve robots.txt’ye uyduklarını belirtir. Kimliğini gizleyen yazılımlar bu kuralların dışındadır; onlar için hız sınırı, IP engelleme ve güvenlik duvarı kuralları gerekir.
llms.txt dosyası oluşturmak gerekli mi?
Bu dosya bir öneridir ve botların onu okuduğuna dair bağlayıcı bir standart yoktur. Erişimi yöneten dosya hâlâ robots.txt’dir. Önce robots.txt kurallarını doğru yazmak gerekir.
Narhost’ta
Web hosting paketlerimizde erişim günlüklerine ve kaynak kullanım grafiğine cPanel’den ulaşır, bot kurallarınızı kendiniz yönetirsiniz.