Kısaca özet
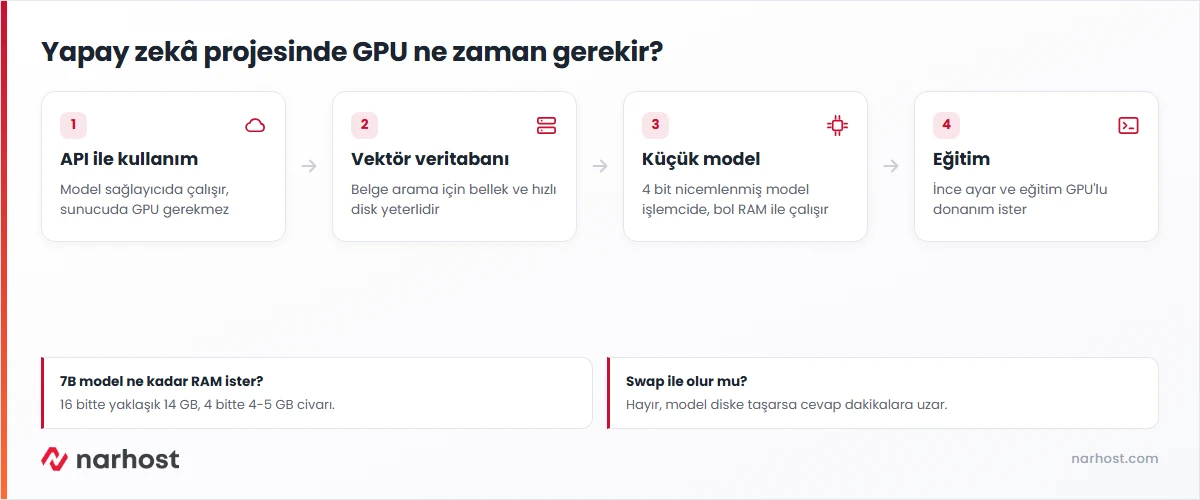
- Yapay zeka sunucu kiralama kararında ilk soru GPU değil, modeli kimin çalıştıracağıdır: bir yapay zekâ servisini API ile kullanıyorsanız sunucunuzda GPU gerekmez, sıradan bir VPS ya da VDS yeter.
- Modeli kendi sunucunuzda barındırmak iki ayrı iştir: eğitim neredeyse her zaman GPU ister, hazır bir modelle cevap üretmek (çıkarım) ise küçük modellerde işlemciyle de mümkündür.
- Bellek hesabı basittir: 16 bit hassasiyette milyar parametre başına yaklaşık 2 GB gerekir; 7 milyar parametreli bir model 14 GB civarı ister, 4 bit nicemlemeyle bu ihtiyaç kabaca dörtte birine iner.
- İşlemcide çalışan modelde darboğaz bellek hızı ve çekirdek sayısıdır; tek kullanıcılı, gecikmeye toleranslı işler için uygundur, çok kullanıcılı canlı sohbet için yetersiz kalır.
- Vektör veritabanı, gömme (embedding) üretimi, API tabanlı sohbet botu, belge arama ve iş akışı otomasyonu GPU’suz sunucuda rahat çalışan yapay zekâ işleridir.
- Büyük model eğitimi, ince ayar (fine-tuning) ve yüksek eşzamanlı çıkarım için GPU’lu donanım gerekir; bu işlerde işlemci sunucusu doğru araç değildir.
Bir yapay zekâ projesi planlıyorsunuz ve ilk bulduğunuz tavsiye “GPU’lu sunucu kirala” oluyor. Fiyatlara bakınca proje daha başlamadan bütçe aşılıyor. Oysa yapay zeka sunucu kiralama sorusunun cevabı çoğu zaman beklenenden sadedir: işin önemli bir kısmı GPU olmadan, sıradan bir sunucuda yürür.
Yapay Zeka Sunucu Kiralama Öncesi İlk Soru, API mi Kendi Model mi
Yapay zekâ kullanan uygulamaların büyük kısmı modeli kendisi çalıştırmaz. Sohbet botu, metin özetleyen bir araç ya da müşteri e-postalarını sınıflandıran bir sistem, çoğunlukla bir yapay zekâ sağlayıcısının API’sine istek gönderir ve gelen cevabı işler. Bu mimaride ağır hesaplama sağlayıcının veri merkezinde yapılır. Sizin sunucunuzun görevi web uygulamasını çalıştırmak, isteği hazırlamak, cevabı veritabanına yazmak ve kullanıcıya göstermektir.
Bu iş için gereken şey bir web uygulamasının ihtiyacından farklı değildir: birkaç çekirdek, uygulamanın ve veritabanının sığacağı kadar bellek, kalıcı çalışan süreçler için kök erişimi. Python ya da Node.js ile yazılmış bu tür bir uygulamanın barındırma seçeneklerini Python ve Node.js için hangi hosting yazısında bulabilirsiniz. GPU bu senaryoda hiçbir işe yaramaz, yalnızca faturayı büyütür.
Bilgi
API ile çalışan bir uygulamada maliyet kalemi sunucu değil, sağlayıcıya gönderilen istek hacmidir. Sunucuyu büyütmek cevabı hızlandırmaz; cevap süresini sağlayıcının modeli belirler.
Model Barındırmak, Eğitim ve Çıkarım Ayrımı
Modeli kendi sunucunuzda çalıştırmak istemenizin geçerli nedenleri olabilir: veri dışarı çıkmamalıdır, istek hacmi API maliyetini aşmıştır ya da internet bağlantısı olmadan çalışan bir sistem gerekir. Bu noktada iki işi ayırmak gerekir.
Eğitim, modelin ağırlıklarını veriden öğrenerek oluşturmaktır. Sıfırdan eğitim ya da mevcut bir modelin ince ayarı, milyarlarca sayı üzerinde tekrar tekrar yapılan matris işlemleri demektir ve bu iş için GPU’nun paralel hesaplama gücü gerçek anlamda şarttır. Çıkarım ise eğitilmiş bir modelle cevap üretmektir. Burada hesaplama yükü çok daha küçüktür ve küçük modellerde işlemci de işi görür; ancak hız GPU’ya göre belirgin biçimde düşüktür.
| İş | GPU gerekir mi | İşlemci sunucusunda durum |
|---|---|---|
| API ile sohbet botu ya da metin işleme | Hayır | Rahat çalışır, sıradan web uygulaması gibi |
| Vektör veritabanı ve belge arama | Hayır | Bellek ve disk hızı belirleyicidir |
| Küçük gömme modeliyle vektör üretimi | Genellikle hayır | Toplu işlerde yavaş ama kabul edilebilir |
| 7–8 milyar parametreli modelle çıkarım | Hız için evet | 4 bit nicemlemeyle çalışır, tek kullanıcıda kullanılabilir |
| İnce ayar ve eğitim | Evet | Pratikte uygun değil |
Bellek Hesabı, Model Boyutu Ne Kadar RAM İster
Bir modelin bellek ihtiyacını tahmin etmek için parametre sayısına ve ağırlıkların hassasiyetine bakılır. Hugging Face’in büyük dil modeli optimizasyon rehberi kuralı açıkça verir: X milyar parametreli bir modelin ağırlıklarını 16 bit hassasiyette yüklemek yaklaşık 2 × X GB bellek ister. Aynı rehbere göre 8 ve 4 bit nicemleme (quantization) bu ihtiyacı belirgin biçimde düşürür; karşılığı doğrulukta küçük bir kayıptır.
Pratikte bunun anlamı şudur: 7 milyar parametreli bir model 16 bit hâlinde 14 GB civarı, 4 bit nicemlenmiş hâlinde ise 4–5 GB civarı bellek ister. Buna modelin uzun metinleri işlerken tuttuğu ara bellek, işletim sistemi ve uygulamanızın kendisi eklenir. İşlemcide çalışan modelde bu bellek GPU belleği değil sunucunun RAM’idir; bu yüzden işlemciyle model çalıştıracaksanız RAM, çekirdek sayısından önce gelen kalemdir.
Dikkat
Belleğe sığmayan bir modeli takas alanıyla (swap) çalıştırmaya çalışmayın. Model her cevapta ağırlıkların tamamını okur; ağırlıklar diske taşarsa cevap üretimi dakikalara uzar ve sunucudaki diğer her şey de yavaşlar. Modelin nicemlenmiş boyutu, sunucunun boştaki belleğinin rahatça altında kalmalıdır.
İşlemciyle Model Çalıştırmanın Sınırları
İşlemcide çıkarım için en yaygın araç llama.cpp ve onu temel alan araçlardır. Proje, amacını geniş bir donanım yelpazesinde en az kurulumla model çalıştırmak olarak tanımlar; x86 işlemcilerde AVX, AVX2 ve AVX-512 komut setlerini kullanır ve 1,5 bitten 8 bite kadar nicemleme destekler. Yani 7–8 milyar parametreli bir model, yeterli belleği olan çok çekirdekli bir sunucuda GPU olmadan çalışır.
Sınır hızdadır. İşlemcide cevap üretimi GPU’ya göre belirgin biçimde yavaştır ve hız, bellek bant genişliği ile çekirdek sayısıyla sınırlıdır. Tek bir kullanıcının gece çalışan bir özetleme görevi, iç belgeler üzerinde soru cevap ya da cevabın birkaç saniye gecikmesinin sorun olmadığı bir araç için bu hız yeterlidir. Aynı anda onlarca kullanıcının canlı sohbet ettiği bir ürün için ise yeterli değildir; böyle bir ürün ya API’ye ya da GPU’lu donanıma dayanmalıdır.
Örnek senaryo
Yirmi kişilik bir muhasebe bürosu, müşteri sözleşmelerinden belirli maddeleri bulan bir iç araç istedi ve belgelerin dışarı çıkmamasını şart koştu. Ekip 8 çekirdek ve 32 GB bellekli bir sunucuya 4 bit nicemlenmiş 8 milyar parametreli bir model, küçük bir gömme modeli ve bir vektör veritabanı kurdu. Belgeler gece toplu işlendi; gündüz gelen sorulara cevap birkaç saniye sürdü. Aynı anda en fazla üç kişi kullandığı için GPU’ya gerek kalmadı.
GPU Olmadan Sunucuda Yapılabilecek Yapay Zekâ İşleri
GPU’suz bir sunucu, yapay zekâ projelerinin görünmeyen ama iş yükünün çoğunu taşıyan kısmını rahatça üstlenir. Bunların başında API tabanlı uygulamalar gelir: sohbet arayüzü, müşteri destek asistanı, içerik sınıflandırma ya da form verisini ayrıştıran bir servis. İkinci grup vektör veritabanlarıdır; belgeleri parçalara bölüp anlam vektörleri olarak saklayan ve soruya en yakın parçayı bulan bu sistemler bellek ve hızlı disk ister, GPU istemez.
Üçüncü grup küçük modellerdir: metin sınıflandırma, dil tespiti, gömme üretimi ve küçük boyutlu dil modelleri işlemcide makul hızda çalışır. Dördüncü grup ise iş akışı otomasyonudur; bir e-postayı alıp yapay zekâ servisine gönderen, cevabı bir tabloya yazan ve ilgili kişiye bildirim atan akışlar tamamen işlemci ve ağ işidir. Bu servislerin çoğu Docker ile kurulur; kurulum adımları Ubuntu’da Docker kurulumu kartında anlatılıyor.
Kaynak Tablosu, Hangi İş İçin Ne Kadar Sunucu
Aşağıdaki değerler temkinli başlangıç noktalarıdır. Model barındıran senaryolarda belirleyici olan RAM’dir; paket seçerken önce modelin nicemlenmiş boyutunu, sonra eşzamanlı kullanıcı sayısını hesaba katın. Genel kaynak hesabının mantığını VPS için ne kadar RAM ve CPU gerekir yazısında ayrıntılı bulabilirsiniz.
| Senaryo | vCPU | RAM | Not |
|---|---|---|---|
| API tabanlı uygulama ve veritabanı | 2 | 2–4 GB | Sıradan web uygulaması gibi |
| Vektör veritabanı, birkaç bin belge | 2–4 | 4–8 GB | NVMe disk arama hızını etkiler |
| Gömme modeli ve belge işleme | 4 | 8 GB | Toplu işleri gece çalıştırın |
| 4 bit nicemlenmiş 7–8 milyar parametreli model | 8 ve üzeri | 16–32 GB | Tek ya da birkaç kullanıcı |
Narhost’ta İşlemci Tabanlı Yapay Zekâ Sunucusu
Model barındıran senaryolarda çekirdeklerin size ayrılmış olması önemlidir; çıkarım sırasında tüm çekirdekler aynı anda yüklenir ve paylaşılan çekirdekte hız dalgalanır. Bu yüzden yapay zeka sunucu kiralama planında işlemciyle model çalıştıracaksanız VDS daha tutarlı sonuç verir. Narhost VDS’te kaynaklar size ayrılır, NVMe disk ve 50 Gbps port standarttır, Ubuntu, Debian ve AlmaLinux gibi dağıtımlar siparişte seçilir ve sunucu anında kurulur.
VDS yönetimsiz bir üründür: model, çalışma ortamı, güvenlik ve yedek sizin sorumluluğunuzdadır. Paketler ve güncel kaynak seçenekleri VDS sunucu sayfasında; paylaşımlı çekirdek ile ayrılmış çekirdek farkı ise VPS mi VDS mi bulut sunucu mu karşılaştırmasında ayrıntılı anlatılıyor.
Sonuç
GPU, eğitim ve yoğun canlı çıkarım için şarttır; geri kalan işlerin çoğu için değildir. API ile çalışıyorsanız sıradan bir sunucu yeter. Küçük bir modeli kendiniz barındıracaksanız RAM’i modelin nicemlenmiş boyutuna göre seçin, çekirdekleri size ayrılmış bir sunucu tercih edin ve eşzamanlı kullanıcı sayısını gerçekçi tahmin edin.
Kontrol Listesi, Sunucuyu Seçmeden Önce
- Modeli kendiniz mi çalıştıracaksınız, yoksa bir API mi kullanacaksınız, netleştirin.
- Eğitim ya da ince ayar gerekip gerekmediğini belirleyin; gerekiyorsa GPU’lu donanım planlayın.
- Kullanacağınız modelin parametre sayısını ve nicemlenmiş dosya boyutunu yazın.
- RAM’i model boyutu, bağlam belleği, işletim sistemi ve uygulamanın toplamına göre seçin.
- Aynı anda kaç kişinin cevap bekleyeceğini ve kabul edilebilir cevap süresini belirleyin.
- Verinin sunucu dışına çıkıp çıkamayacağını hukuk ve müşteri sözleşmeleri açısından kontrol edin.
- Model dosyaları ve vektör veritabanı için yedek planı yapın.
Sıkça sorulan sorular
Yapay zeka sunucu kiralama için mutlaka GPU’lu paket mi gerekir?
Hayır. Bir yapay zekâ servisini API ile kullanan uygulamalar, vektör veritabanları, belge arama ve otomasyon akışları GPU’suz sunucuda çalışır. GPU eğitim, ince ayar ve çok kullanıcılı canlı çıkarım için gerekir.
ChatGPT benzeri bir modeli kendi sunucumda çalıştırabilir miyim?
Açık ağırlıklı küçük ve orta boy modelleri çalıştırabilirsiniz. 7–8 milyar parametreli bir model 4 bit nicemlemeyle 16 GB ve üzeri belleği olan çok çekirdekli bir sunucuda çalışır. Büyük ticari modellerin kalitesini ve hızını beklemeyin; tek ya da birkaç kullanıcılı iç araçlar için uygundur.
İşlemcide çalışan model neden yavaş?
Her yeni kelime üretilirken modelin ağırlıklarının büyük kısmı bellekten okunur. GPU bunu çok yüksek bant genişliğiyle yapar, işlemci ise sunucu belleğinin hızıyla sınırlıdır. Nicemleme okunacak veriyi küçülttüğü için hızı artırır; çekirdek sayısı da bir noktaya kadar yardımcı olur.
Paylaşımlı hostingte yapay zekâ uygulaması çalışır mı?
API’ye istek gönderen basit bir PHP betiği çalışabilir. Model barındırmak, vektör veritabanı kurmak ya da sürekli çalışan bir Python servisi açmak ise paylaşımlı hostingin kaynak sınırlarına ve SSH olmamasına takılır. Bu işler için kök erişimli bir VPS ya da VDS gerekir.
Vektör veritabanı için ne kadar bellek gerekir?
Belge sayısına, vektör boyutuna ve kullanılan dizin türüne bağlıdır. Birkaç bin belgelik bir iç arama sistemi 4–8 GB bellekle rahat çalışır. Belge sayısı yüz binlere çıktığında dizinin belleğe sığması için RAM’i büyütmek ya da disk tabanlı dizinlere geçmek gerekir.
Narhost’ta
VDS sunucularımızda çekirdekler size ayrılır; NVMe disk, 50 Gbps port ve anında kurulumla API tabanlı uygulamanızı, vektör veritabanınızı ya da küçük modelinizi çalıştırabilirsiniz.